Del 28 al 30 de septiembre de 2026, parte del equipo de Myukura trabajó en Barcelona dentro del 8.º MareNostrum Hackathon — MNHACK26, organizado por el Barcelona Supercomputing Center junto con NVIDIA, bajo el paraguas de Open Hackathons y con Do IT Now como patrocinador.
La convocatoria nos había llegado a través del programa NVIDIA Inception, del que Myukura forma parte.
Fuimos seleccionados con una propuesta centrada en uno de los problemas técnicos que atraviesan todo nuestro producto: el reconocimiento automático de voz clínica en español.
Por qué la voz clínica es un problema distinto
Convertir voz en texto parece hoy una tecnología prácticamente resuelta.
En condiciones controladas, algunos sistemas modernos ofrecen resultados extraordinarios.
Pero una consulta no es una grabación preparada para un benchmark.
Hay interrupciones, diferentes distancias respecto al micrófono, pronunciaciones rápidas, nombres propios, medicamentos, cantidades, dosis, siglas y formas de hablar que cambian entre regiones y personas.
Y, además, existe una diferencia crítica entre equivocarse en una palabra cotidiana y hacerlo en información clínicamente relevante.
No todos los errores tienen el mismo impacto.
Por eso, cuando evaluamos reconocimiento de voz para Myukura, no nos interesa únicamente una cifra global.
Nos interesa comprender qué se equivoca, cuándo se equivoca y qué tipo de información resulta más difícil de reconocer.
Español, terminología y acentos
Una parte importante de los grandes datasets de voz y de los modelos más utilizados se ha desarrollado con una fuerte presencia del inglés.
El español presenta sus propios retos.
Y dentro del español existe, además, una variabilidad enorme entre países, regiones y hablantes.
Para una empresa nacida en Andalucía, cuestiones como el reconocimiento de diferentes acentos no son una consideración académica.
Son parte del entorno real donde esperamos que esta tecnología pueda utilizarse.
A ello se suma el vocabulario clínico: fármacos, principios activos, unidades, dosis y términos poco frecuentes en conversaciones generales.
Nuestro trabajo durante el hackathon se centró precisamente en avanzar sobre estas limitaciones.
Qué hicimos durante el hackathon
El formato del MareNostrum Hackathon no era competitivo.
El objetivo era que cada equipo pudiera utilizar infraestructura de computación de alto rendimiento, trabajar sobre su propio problema y recibir acompañamiento técnico de los mentores.
Durante las jornadas entrenamos y evaluamos nuestros propios modelos, probamos distintas configuraciones y analizamos resultados para comprender mejor cómo respondían los modelos ante nuestro caso de uso.
Tener acceso a infraestructura GPU de alto rendimiento permitió acelerar una parte del trabajo experimental y, sobre todo, realizar comparaciones que resultan difíciles de ejecutar con recursos más limitados.
Pero la parte más valiosa no fue simplemente disponer de más potencia de cálculo.
Fue poder utilizarla para formular mejores preguntas.
Medir antes de integrar
En productos basados en inteligencia artificial existe una tentación frecuente: encontrar un modelo con buenos resultados públicos y comenzar inmediatamente a construir encima.
Nuestra experiencia está siendo la contraria.
Antes de integrar un modelo en una arquitectura clínica necesitamos entender sus límites.
Eso significa medir.
No únicamente medir precisión general, sino examinar patrones de error, condiciones de audio, vocabulario, generalización y requisitos computacionales.
El hackathon nos permitió avanzar precisamente en esa dirección.
MareNostrum 5 y el valor de experimentar sobre infraestructura real
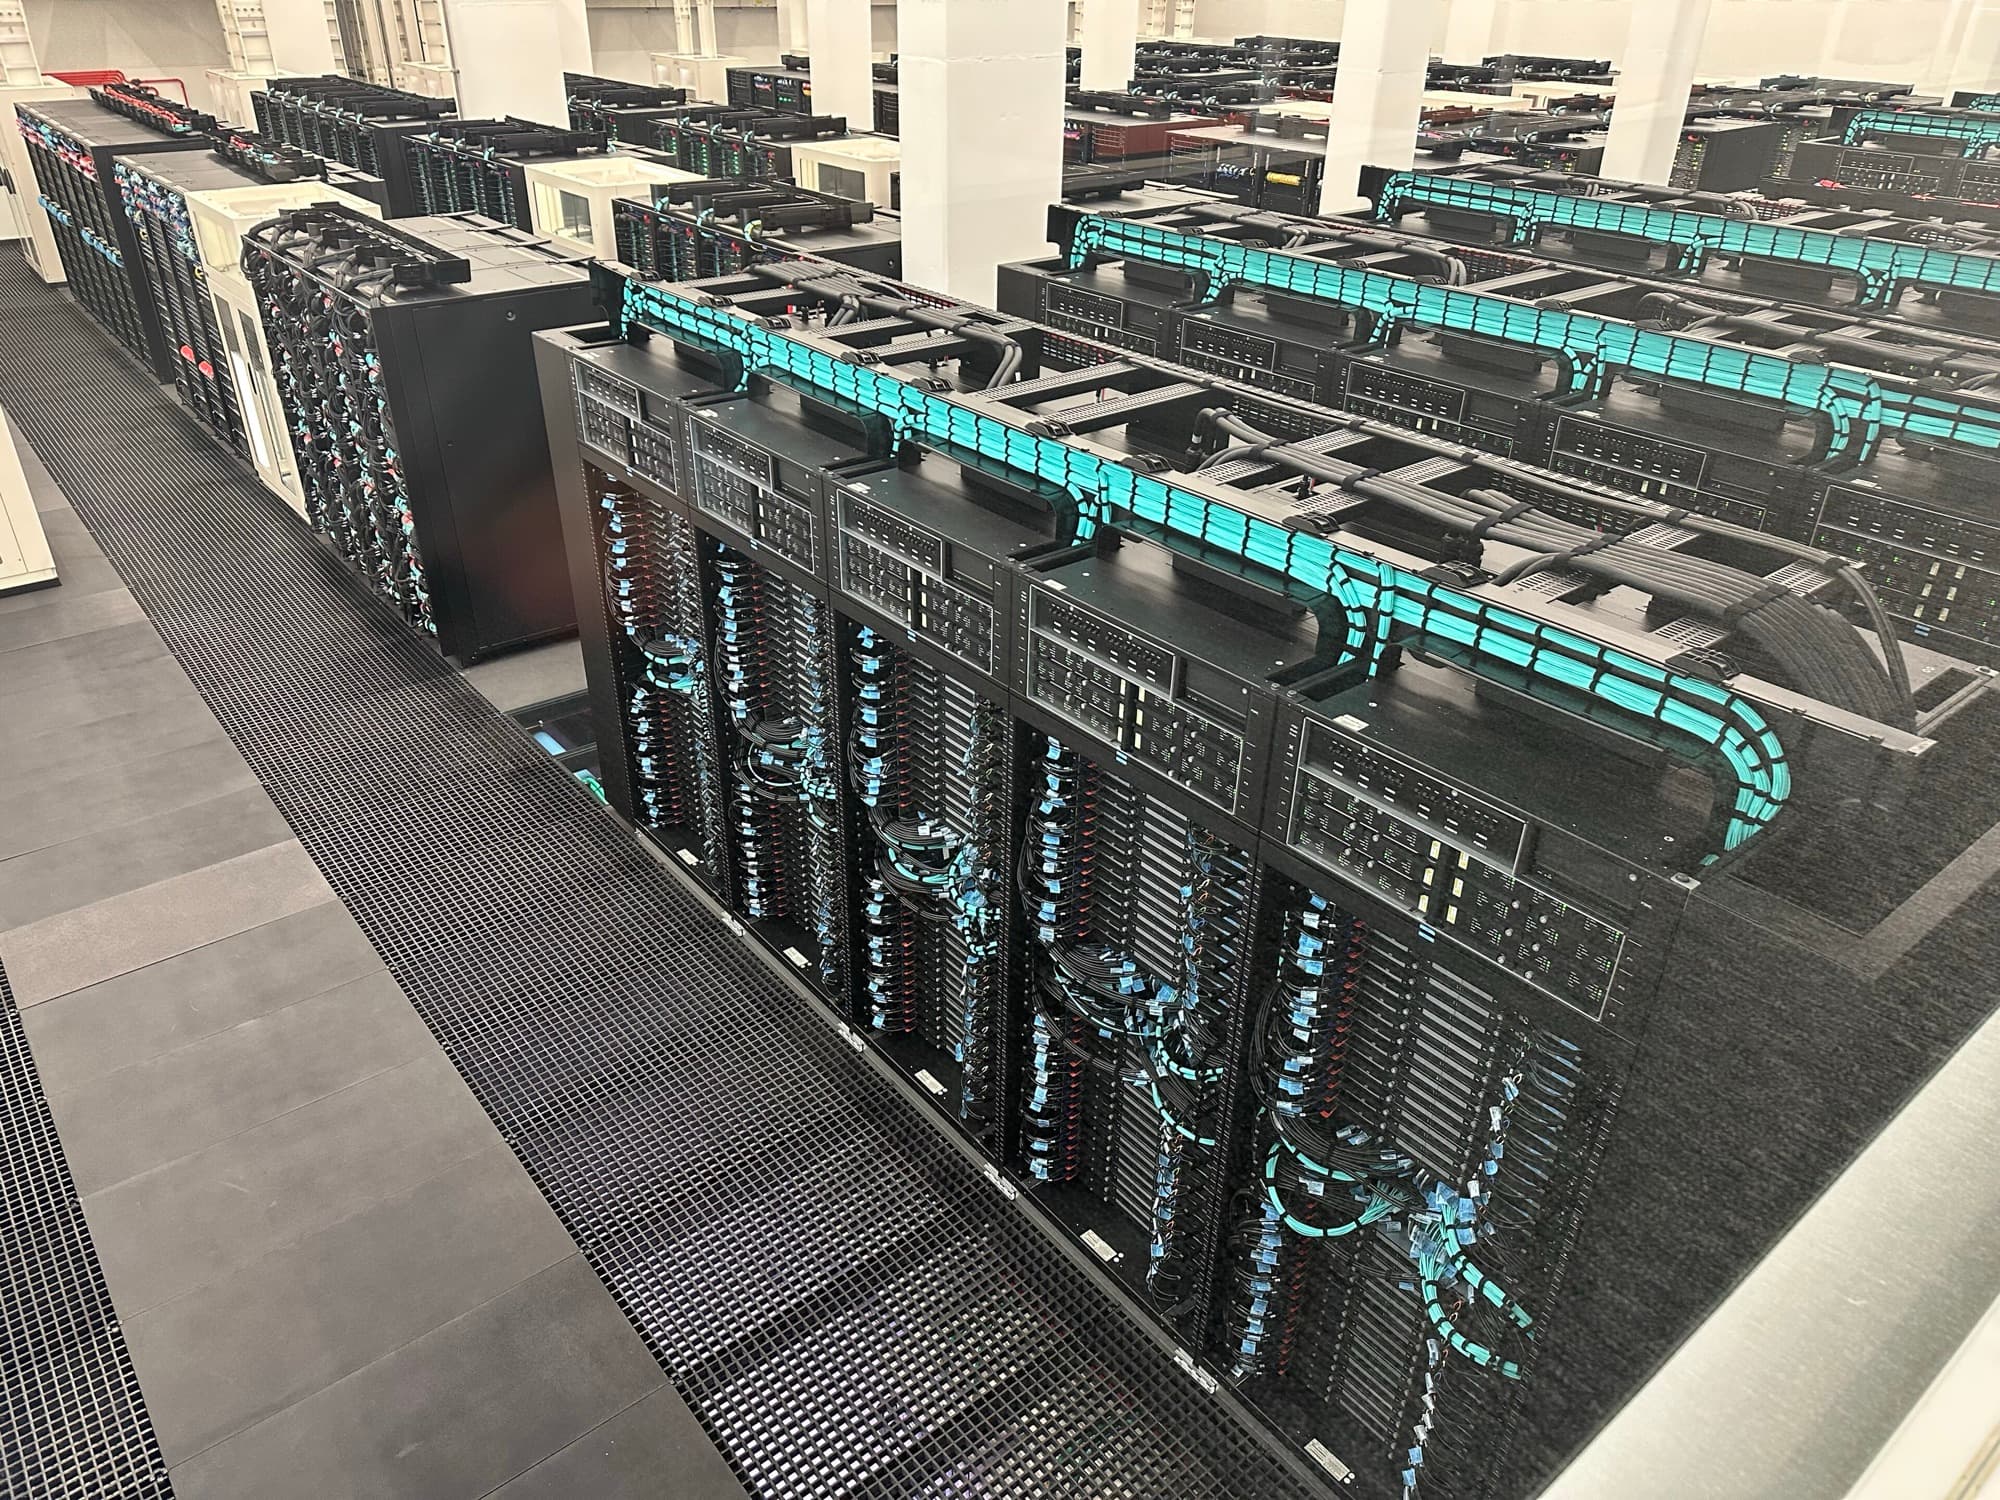
El Barcelona Supercomputing Center alberga MareNostrum 5, uno de los grandes sistemas europeos de supercomputación.
Trabajar en un entorno de estas características permite investigar modelos y configuraciones que, por sus necesidades de computación, resultarían mucho más difíciles de explorar desde infraestructura convencional.
Para una startup, disponer durante unos días de ese contexto y del acompañamiento de especialistas representa una oportunidad poco habitual.
Nos permitió acelerar experimentos.
Pero también entender mejor cuáles merecía la pena seguir haciendo.
Lo que continúa después de Barcelona
El hackathon no cierra esta línea de trabajo.
La abre.
Volvemos con resultados, pero también con una imagen más precisa de las limitaciones actuales y de las siguientes preguntas que necesitamos responder.
Seguiremos trabajando sobre reconocimiento de voz clínico en español, adaptación de modelos y evaluación de sistemas especializados dentro de nuestra línea de I+D.
Nuestro objetivo no es entrenar modelos por entrenarlos.
El objetivo es determinar qué arquitectura puede ofrecer resultados suficientemente consistentes para ayudar a documentar una consulta manteniendo siempre la revisión del profesional.
Agradecimientos
Queremos agradecer al Barcelona Supercomputing Center la oportunidad de participar y trabajar en sus instalaciones; a NVIDIA y a los mentores que nos acompañaron técnicamente durante las jornadas; a NVIDIA Inception, a través de cuyo programa conocimos la convocatoria; a Do IT Now por su participación como patrocinador; y a OpenACC y Open Hackathons por el trabajo de organización y por crear un entorno donde empresas, investigadores e ingenieros pueden experimentar sobre problemas reales.
Fuentes
Sigue leyendo
- NVIDIA Inception y la línea de I+D de Myukura: modelos especializados e inteligencia artificial localTecnología · 5 de octubre de 2026
- Más grande no siempre significa mejor: el papel de los modelos especializados en IA clínicaInvestigación · 5 de octubre de 2026
- NVIDIA Nemotron 3 Diarization: por qué separar correctamente a los hablantes importa en una consulta médicaIA clínica · 5 de octubre de 2026