De 28 a 30 de setembro de 2026, parte da equipa da Myukura trabalhou em Barcelona no âmbito do 8.º MareNostrum Hackathon — MNHACK26, organizado pelo Barcelona Supercomputing Center juntamente com a NVIDIA, sob a égide da Open Hackathons e com a Do IT Now como patrocinador.
A convocatória tinha chegado até nós através do programa NVIDIA Inception, de que a Myukura faz parte.
Fomos selecionados com uma proposta centrada num dos problemas técnicos que atravessam todo o nosso produto: o reconhecimento automático de voz clínica em espanhol.
Porque a voz clínica é um problema diferente
Converter voz em texto parece hoje uma tecnologia praticamente resolvida.
Em condições controladas, alguns sistemas modernos oferecem resultados extraordinários.
Mas uma consulta não é uma gravação preparada para um benchmark.
Há interrupções, diferentes distâncias em relação ao microfone, pronúncias rápidas, nomes próprios, medicamentos, quantidades, doses, siglas e formas de falar que mudam entre regiões e pessoas.
E existe ainda uma diferença crítica entre errar numa palavra quotidiana e fazê-lo em informação clinicamente relevante.
Nem todos os erros têm o mesmo impacto.
Por isso, quando avaliamos reconhecimento de voz para a Myukura, não nos interessa apenas um valor global.
Interessa-nos compreender em que se engana, quando se engana e que tipo de informação é mais difícil de reconhecer.
Espanhol, terminologia e sotaques
Uma parte importante dos grandes conjuntos de dados de voz e dos modelos mais utilizados foi desenvolvida com uma forte presença do inglês.
O espanhol apresenta os seus próprios desafios.
E dentro do espanhol existe, além disso, uma enorme variabilidade entre países, regiões e falantes.
Para uma empresa nascida na Andaluzia, questões como o reconhecimento de diferentes sotaques não são uma consideração académica.
Fazem parte do ambiente real em que esperamos que esta tecnologia possa ser utilizada.
A isto soma-se o vocabulário clínico: fármacos, princípios ativos, unidades, doses e termos pouco frequentes em conversas gerais.
O nosso trabalho durante o hackathon centrou-se precisamente em avançar perante estas limitações.
O que fizemos durante o hackathon
O formato do MareNostrum Hackathon não era competitivo.
O objetivo era que cada equipa pudesse utilizar infraestrutura de computação de alto desempenho, trabalhar sobre o seu próprio problema e receber acompanhamento técnico dos mentores.
Durante as jornadas treinámos e avaliámos os nossos próprios modelos, testámos diferentes configurações e analisámos resultados para compreender melhor como respondiam os modelos ao nosso caso de uso.
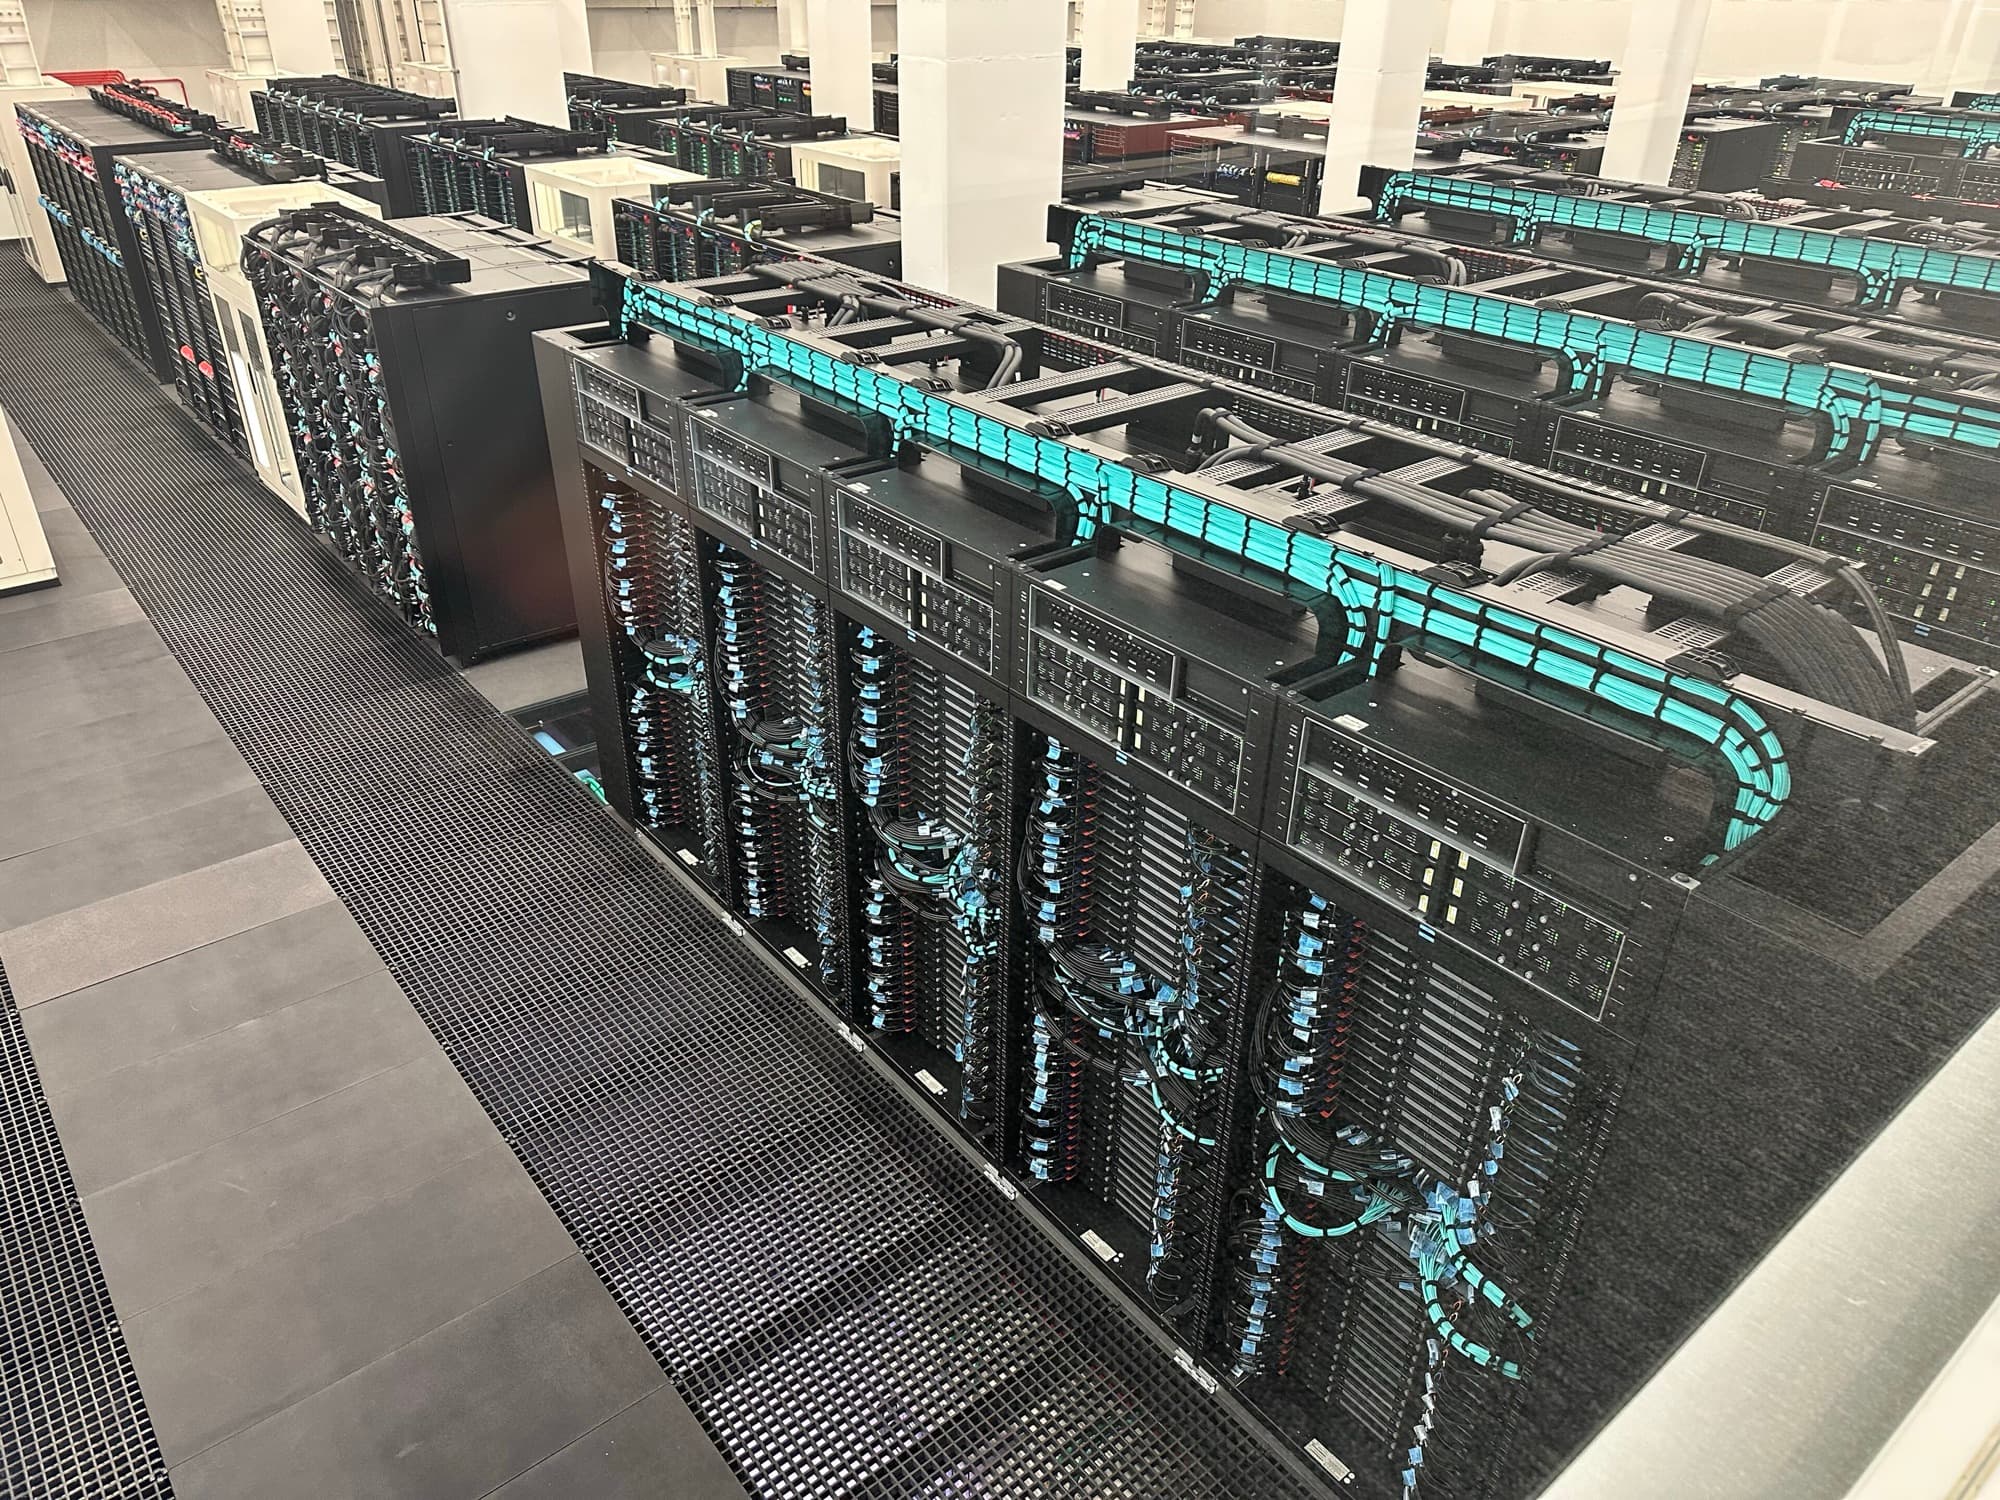
Ter acesso a infraestrutura GPU de alto desempenho permitiu acelerar parte do trabalho experimental e, sobretudo, realizar comparações difíceis de executar com recursos mais limitados.
Mas a parte mais valiosa não foi simplesmente dispor de mais poder de cálculo.
Foi poder utilizá-lo para formular melhores perguntas.
Medir antes de integrar
Em produtos baseados em inteligência artificial existe uma tentação frequente: encontrar um modelo com bons resultados públicos e começar de imediato a construir sobre ele.
A nossa experiência está a ser a contrária.
Antes de integrar um modelo numa arquitetura clínica precisamos de compreender os seus limites.
Isso significa medir.
Não apenas medir a precisão geral, mas examinar padrões de erro, condições de áudio, vocabulário, generalização e requisitos computacionais.
O hackathon permitiu-nos avançar precisamente nessa direção.
MareNostrum 5 e o valor de experimentar sobre infraestrutura real
O Barcelona Supercomputing Center alberga o MareNostrum 5, um dos grandes sistemas europeus de supercomputação.
Trabalhar num ambiente com estas características permite investigar modelos e configurações que, pelas suas necessidades de computação, seriam muito mais difíceis de explorar a partir de infraestrutura convencional.
Para uma startup, dispor durante alguns dias desse contexto e do acompanhamento de especialistas representa uma oportunidade pouco habitual.
Permitiu-nos acelerar experiências.
Mas também perceber melhor quais valia a pena continuar a fazer.
O que continua depois de Barcelona
O hackathon não encerra esta linha de trabalho.
Abre-a.
Voltamos com resultados, mas também com uma imagem mais precisa das limitações atuais e das próximas perguntas a que precisamos de responder.
Continuaremos a trabalhar em reconhecimento de voz clínico em espanhol, adaptação de modelos e avaliação de sistemas especializados dentro da nossa linha de I&D.
O nosso objetivo não é treinar modelos por treinar.
O objetivo é determinar que arquitetura pode oferecer resultados suficientemente consistentes para ajudar a documentar uma consulta mantendo sempre a revisão do profissional.
Agradecimentos
Queremos agradecer ao Barcelona Supercomputing Center a oportunidade de participar e trabalhar nas suas instalações; à NVIDIA e aos mentores que nos acompanharam tecnicamente durante as jornadas; à NVIDIA Inception, através de cujo programa conhecemos a convocatória; à Do IT Now pela sua participação como patrocinador; e à OpenACC e Open Hackathons pelo trabalho de organização e por criarem um ambiente onde empresas, investigadores e engenheiros podem experimentar sobre problemas reais.
Fontes
Continue a ler
- NVIDIA Inception e a linha de I&D da Myukura: modelos especializados e inteligência artificial localTecnologia · 5 de outubro de 2026
- Maior nem sempre significa melhor: o papel dos modelos especializados na IA clínicaInvestigação · 5 de outubro de 2026
- NVIDIA Nemotron 3 Diarization: porque é importante separar corretamente os falantes numa consulta médicaIA clínica · 5 de outubro de 2026