Du 28 au 30 septembre 2026, une partie de l’équipe de Myukura a travaillé à Barcelone dans le cadre du 8e MareNostrum Hackathon — MNHACK26, organisé par le Barcelona Supercomputing Center avec NVIDIA, sous l’égide d’Open Hackathons et avec Do IT Now comme sponsor.
L’appel nous était parvenu via le programme NVIDIA Inception, dont Myukura fait partie.
Nous avons été sélectionnés avec une proposition centrée sur l’un des problèmes techniques qui traversent l’ensemble de notre produit : la reconnaissance automatique de la parole clinique en espagnol.
Pourquoi la parole clinique est un problème différent
Convertir la voix en texte semble aujourd’hui une technologie pratiquement résolue.
Dans des conditions contrôlées, certains systèmes modernes offrent des résultats extraordinaires.
Mais une consultation n’est pas un enregistrement préparé pour un benchmark.
Il y a des interruptions, des distances différentes par rapport au micro, des prononciations rapides, des noms propres, des médicaments, des quantités, des doses, des sigles et des façons de parler qui varient selon les régions et les personnes.
Et il existe en outre une différence critique entre se tromper sur un mot courant et se tromper sur une information cliniquement pertinente.
Toutes les erreurs n’ont pas le même impact.
C’est pourquoi, lorsque nous évaluons la reconnaissance vocale pour Myukura, nous ne nous intéressons pas seulement à un chiffre global.
Nous voulons comprendre sur quoi il se trompe, quand il se trompe et quel type d’information est le plus difficile à reconnaître.
Espagnol, terminologie et accents
Une part importante des grands jeux de données vocales et des modèles les plus utilisés a été développée avec une forte présence de l’anglais.
L’espagnol présente ses propres défis.
Et au sein de l’espagnol, il existe en outre une énorme variabilité entre pays, régions et locuteurs.
Pour une entreprise née en Andalousie, des questions comme la reconnaissance de différents accents ne relèvent pas d’une considération académique.
Elles font partie de l’environnement réel dans lequel nous espérons que cette technologie sera utilisée.
À cela s’ajoute le vocabulaire clinique : médicaments, principes actifs, unités, doses et termes peu fréquents dans les conversations générales.
Notre travail pendant le hackathon s’est concentré précisément sur la manière de progresser face à ces limites.
Ce que nous avons fait pendant le hackathon
Le format du MareNostrum Hackathon n’était pas compétitif.
L’objectif était que chaque équipe puisse utiliser une infrastructure de calcul haute performance, travailler sur son propre problème et bénéficier de l’accompagnement technique de mentors.
Pendant les journées, nous avons entraîné et évalué nos propres modèles, testé différentes configurations et analysé les résultats pour mieux comprendre comment les modèles répondaient à notre cas d’usage.
L’accès à une infrastructure GPU haute performance a permis d’accélérer une partie du travail expérimental et, surtout, de réaliser des comparaisons difficiles à mener avec des ressources plus limitées.
Mais la partie la plus précieuse n’a pas été simplement de disposer de plus de puissance de calcul.
Ça a été de pouvoir l’utiliser pour formuler de meilleures questions.
Mesurer avant d’intégrer
Dans les produits fondés sur l’intelligence artificielle, la tentation est fréquente : trouver un modèle aux bons résultats publics et commencer immédiatement à construire dessus.
Notre expérience est inverse.
Avant d’intégrer un modèle dans une architecture clinique, nous devons comprendre ses limites.
Cela veut dire mesurer.
Pas seulement la précision globale, mais aussi examiner les schémas d’erreur, les conditions audio, le vocabulaire, la généralisation et les besoins de calcul.
Le hackathon nous a permis d’avancer précisément dans cette direction.
MareNostrum 5 et la valeur d’expérimenter sur une infrastructure réelle
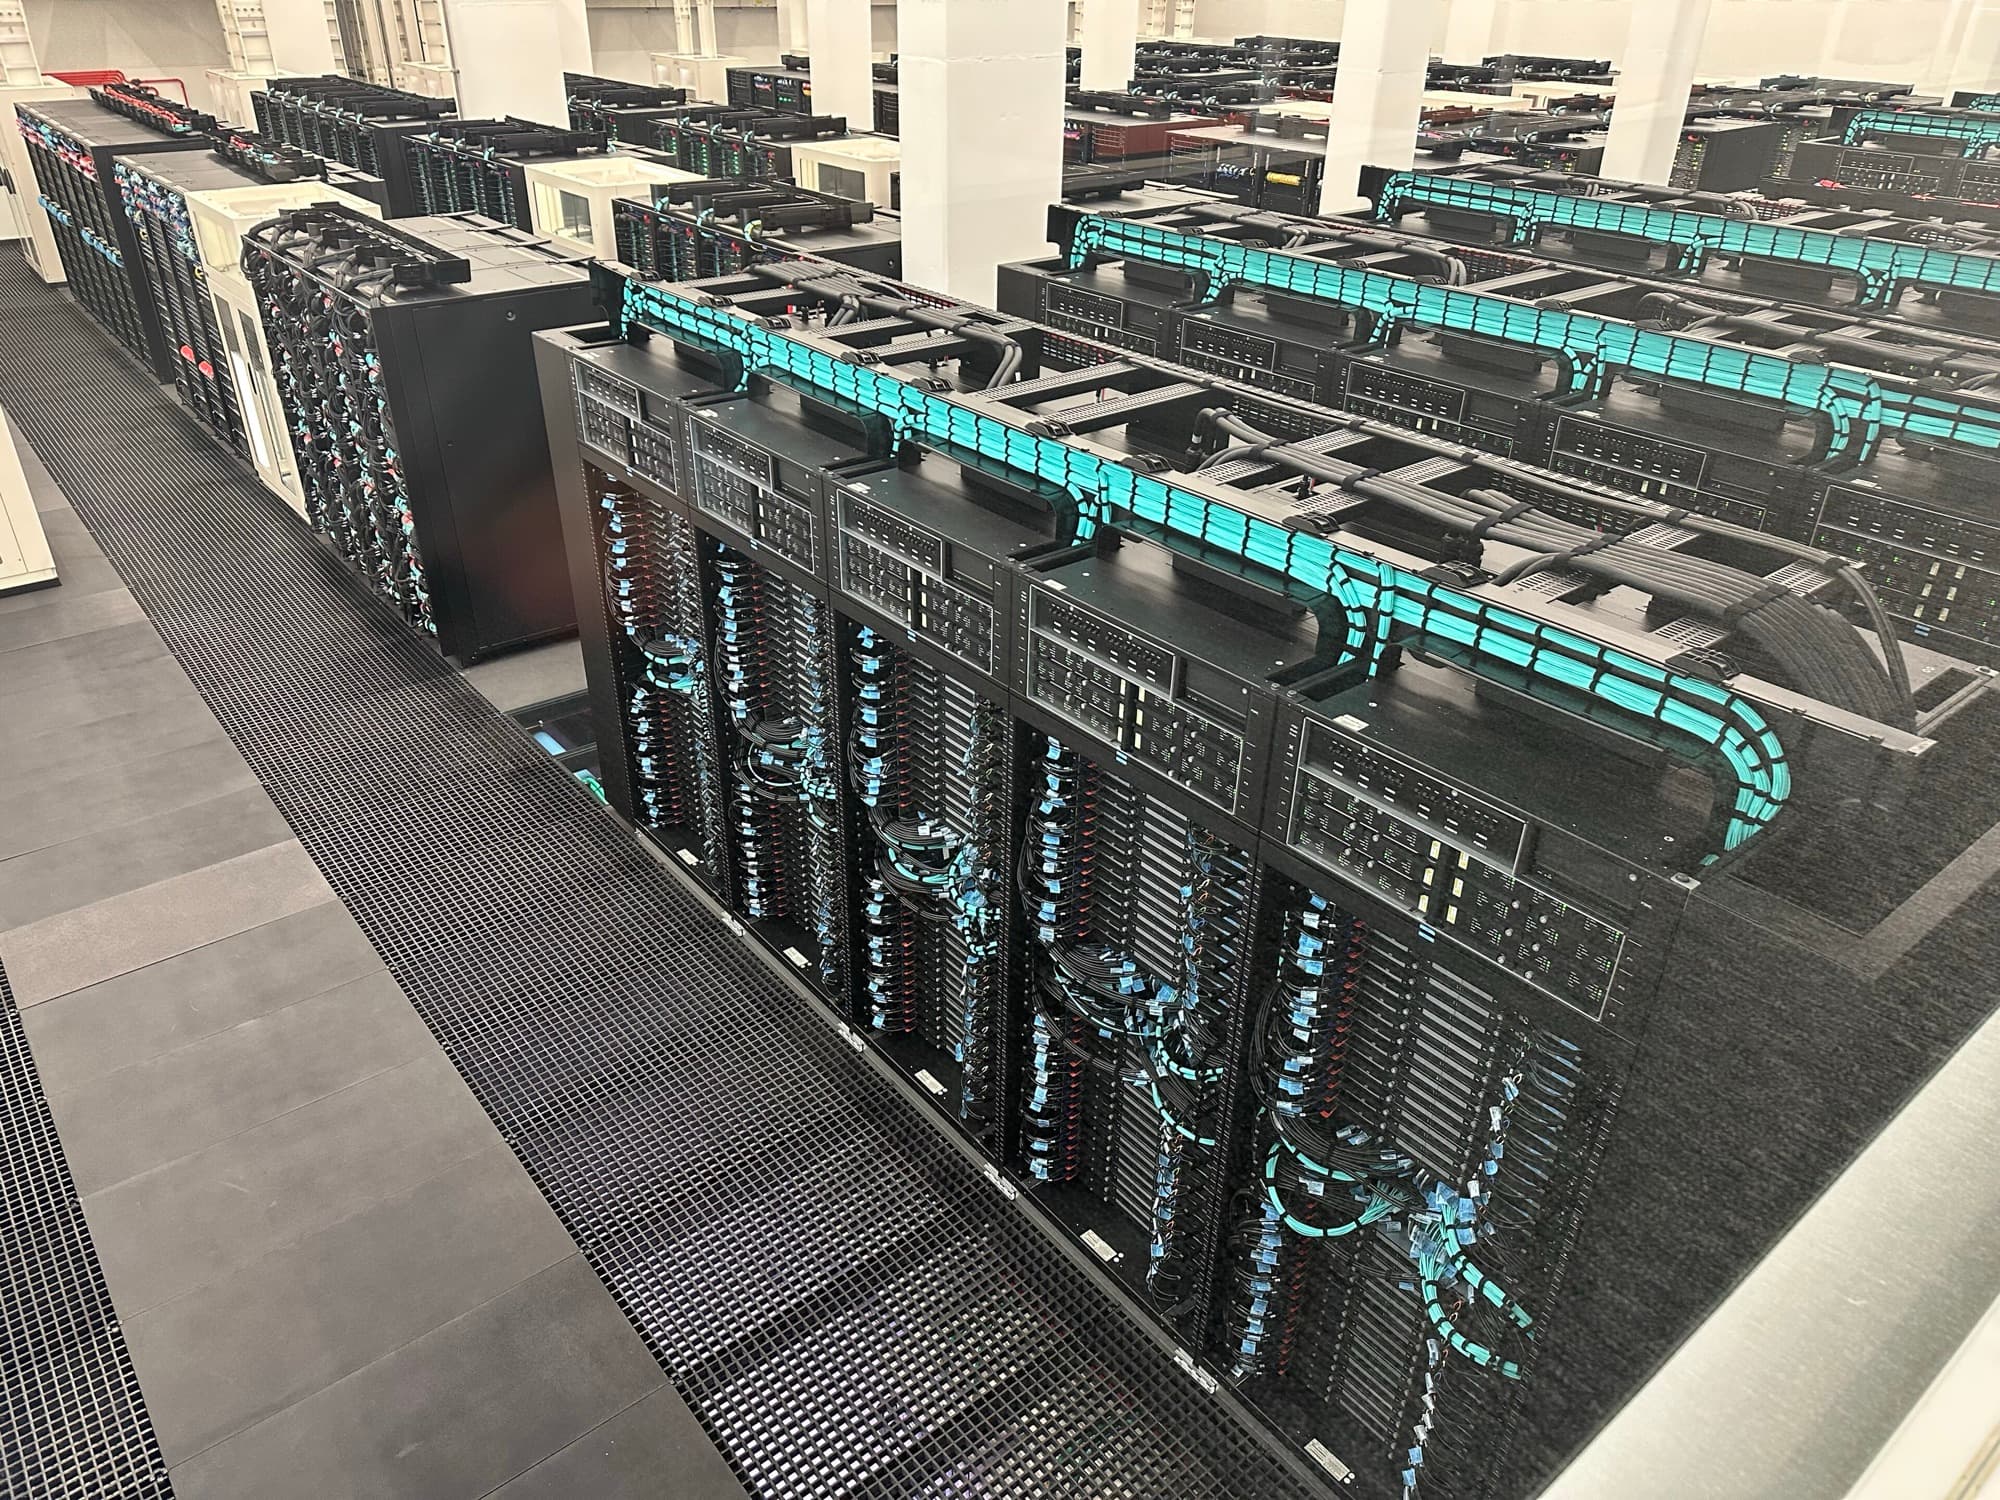
Le Barcelona Supercomputing Center héberge MareNostrum 5, l’un des grands systèmes européens de supercalcul.
Travailler dans un environnement de cette nature permet d’étudier des modèles et des configurations qui, en raison de leurs besoins de calcul, seraient bien plus difficiles à explorer sur une infrastructure conventionnelle.
Pour une startup, disposer pendant quelques jours de ce contexte et de l’accompagnement de spécialistes représente une occasion peu courante.
Cela nous a permis d’accélérer les expériences.
Mais aussi de mieux comprendre lesquelles valaient la peine d’être poursuivies.
Ce qui continue après Barcelone
Le hackathon ne clôt pas cet axe de travail.
Il l’ouvre.
Nous revenons avec des résultats, mais aussi avec une image plus précise des limites actuelles et des prochaines questions auxquelles nous devons répondre.
Nous continuerons de travailler sur la reconnaissance vocale clinique en espagnol, l’adaptation de modèles et l’évaluation de systèmes spécialisés dans le cadre de notre R&D.
Notre objectif n’est pas d’entraîner des modèles pour le plaisir de les entraîner.
L’objectif est de déterminer quelle architecture peut offrir des résultats suffisamment cohérents pour aider à documenter une consultation tout en maintenant toujours la relecture du professionnel.
Remerciements
Nous remercions le Barcelona Supercomputing Center pour l’occasion de participer et de travailler dans ses installations ; NVIDIA et les mentors qui nous ont accompagnés techniquement pendant les journées ; NVIDIA Inception, par le biais de son programme nous avons connu l’appel ; Do IT Now pour sa participation en tant que sponsor ; et OpenACC et Open Hackathons pour le travail d’organisation et pour avoir créé un environnement où entreprises, chercheurs et ingénieurs peuvent expérimenter sur de vrais problèmes.
Sources
Pour aller plus loin
- NVIDIA Inception et l’axe R&D de Myukura : modèles spécialisés et intelligence artificielle localeTechnologie · 5 octobre 2026
- Plus grand ne veut pas toujours dire meilleur : le rôle des modèles spécialisés en IA cliniqueRecherche · 5 octobre 2026
- NVIDIA Nemotron 3 Diarization : pourquoi bien séparer les locuteurs compte lors d’une consultation médicaleIA clinique · 5 octobre 2026